
কারপাথির LLM Wiki: জ্ঞান একবার কম্পাইল হয়, প্রতি প্রশ্নে নতুন করে নয়
অন্দ্রেজ কারপাথি গত এপ্রিলে llm-wiki.md গিস্টে যে ধারণা দিয়েছেন, তাতে RAG-এর মতো প্রতি প্রশ্নে জ্ঞান খোঁজার বদলে একটি স্থায়ী উইকি একবার কম্পাইল করে হালনাগাদ রাখা হয়। মুজাহিদুল ইসলাম শাওন এই ধারণার একটি বাংলা ব্যাখ্যা দিয়েছেন।
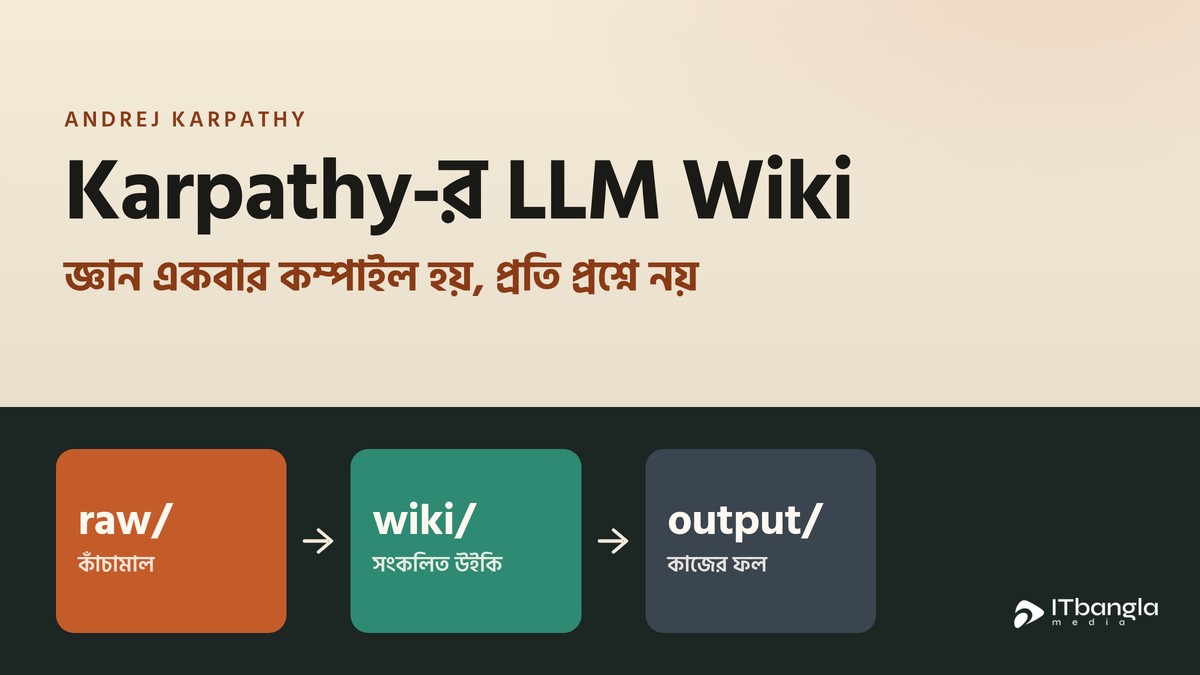
এআই গবেষক অন্দ্রেজ কারপাথি গত এপ্রিলে ব্যক্তিগত জ্ঞানভান্ডার গড়ার একটি ধারণা প্রকাশ করেছেন, যার নাম তিনি দিয়েছেন LLM Wiki। মূল কথাটা এই—সাধারণ RAG ব্যবস্থায় প্রতিটি প্রশ্নে মডেলকে কাঁচা নথি থেকে আবার জ্ঞান খুঁজে বের করতে হয়। কারপাথির প্রস্তাবে একটি স্থায়ী, পরস্পর সংযুক্ত markdown উইকি আগেই তৈরি ও হালনাগাদ রাখা হয়, যেন জ্ঞান একবার কম্পাইল হয়ে জমে থাকে। এই ধারণাটি ৪ এপ্রিল ২০২৬, রাত ১০টা ২৫ মিনিটে (এশিয়া/ঢাকা) GitHub-এ llm-wiki.md নামের একটি গিস্ট হিসেবে প্রকাশিত হয়। এর দুই দিন আগে, ২ এপ্রিল, তিনি এক্স-এ ‘LLM Knowledge Bases’ শিরোনামে একই কর্মপ্রবাহের কথা লেখেন।
বুধবার (১১ নভেম্বর ২০২৬) সকাল ১১টা ৪৮ মিনিটে (এশিয়া/ঢাকা) মুজাহিদুল ইসলাম শাওন এই ধারণার একটি বাংলা ব্যাখ্যা দিয়ে একটি ফেসবুক পোস্ট করেছেন। সেখানে তিনি উইকিকে স্টোরেজ বা ফাইলিং ক্যাবিনেট নয়, বরং একটি কম্পাইলার হিসেবে দেখার কথা বলেছেন এবং raw/, wiki/, output/ ফোল্ডার ও CLAUDE.md ফাইলের একটি জনপ্রিয় বিন্যাস তুলে ধরেছেন। এই প্রতিবেদনে কারপাথির মূল লেখা, সেই জনপ্রিয় ব্যাখ্যা এবং দুইয়ের ফারাক আলাদা করে রাখা হয়েছে।
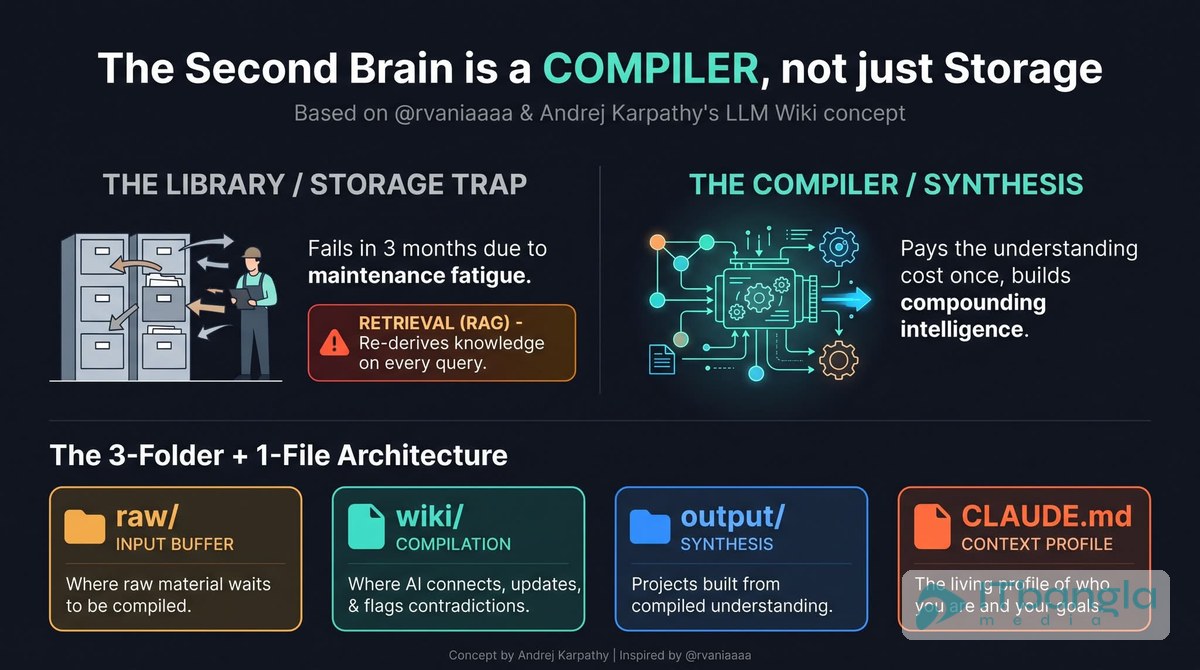
কারপাথি গিস্টে লিখেছেন, বেশিরভাগ মানুষের অভিজ্ঞতা RAG-এর মতো—নথি আপলোড করা হয়, প্রশ্নের সময় প্রাসঙ্গিক অংশ উঠে আসে, তারপর উত্তর তৈরি হয়। এতে কাজ হয়, কিন্তু প্রতিটি প্রশ্নে LLM আবার শূন্য থেকে জ্ঞান খুঁজে বের করে; কিছু জমে না। NotebookLM, ChatGPT-এর ফাইল আপলোড ও অধিকাংশ RAG ব্যবস্থা এভাবেই চলে বলে তিনি উল্লেখ করেছেন।
বিকল্প হিসেবে তিনি একটি স্থায়ী উইকির কথা বলেছেন। নতুন সোর্স যোগ হলে মডেল শুধু ইনডেক্স করে রাখে না; পড়ে, মূল তথ্য তোলে, সংশ্লিষ্ট পেজ আপডেট করে এবং পুরনো দাবির সঙ্গে অমিল থাকলে তা টুকে রাখে। কারপাথির নিজের ভাষায়, জ্ঞান একবার কম্পাইল হয়, তারপর তা হালনাগাদ রাখা হয়; প্রতিটি কোয়েরিতে আবার তৈরি করা হয় না। শাওনের পোস্টে যে লাইনটি উদ্ধৃতি চিহ্নে রাখা হয়েছে—RAG প্রতি কোয়েরিতে নতুন করে জ্ঞান তৈরি করতে চায়, আর একটি কম্পাইল্ড উইকি একবার প্রসেস করে আপডেটেড রাখে—সেটি কারপাথির এই বক্তব্যের কাছাকাছি একটি প্যারাফ্রেজ। একই ধরনের সারকথা ২১ আগস্ট ২০২৬, রাত ১২টা ৫৩ মিনিটে (এশিয়া/ঢাকা) এক্স ব্যবহারকারী @rvaniaaaa-এর একটি বিশ্লেষণেও দেখা যায়। কারপাথির গিস্টে ঠিক এই বাক্যটি নেই।
গিস্টে তিনি তিনটি স্তরের কথা বলেছেন। প্রথমত, raw সোর্স—নিবন্ধ, গবেষণাপত্র, ছবি, ডেটা ফাইল—যা অপরিবর্তনীয় থাকে; মডেল পড়ে, কিন্তু বদলায় না। দ্বিতীয়ত, উইকি—LLM-এর লেখা markdown পেজ, সারসংক্ষেপ, বিষয় ও সত্তার পাতা, তুলনা ও সংযোগ। তৃতীয়ত, একটি schema ফাইল, যেমন Claude Code-এর জন্য CLAUDE.md বা Codex-এর জন্য AGENTS.md, যেখানে উইকির গঠন, নিয়ম ও কর্মপ্রবাহ লেখা থাকে। এই ফাইলটি তিনি ও মডেল একসঙ্গে সময়ের সঙ্গে গড়ে তোলার কথা বলেছেন।
কাজের তিনটি ধাপ তিনি উল্লেখ করেছেন: ingest, query ও lint। নতুন সোর্স এলে মডেল তা পড়ে, সারসংক্ষেপ লেখে, ইনডেক্স ও সংশ্লিষ্ট পেজ আপডেট করে। একটি সোর্স ১০ থেকে ১৫টি উইকি পেজ ছুঁতে পারে বলে তিনি লিখেছেন। প্রশ্ন করলে মডেল প্রাসঙ্গিক পেজ পড়ে উত্তর দেয়, আর ভালো উত্তর আবার উইকিতে নতুন পেজ হিসেবে জমা রাখা যায়। সময়ে সময়ে lint বা স্বাস্থ্যপরীক্ষায় অমিল, পুরনো দাবি, এতিম পেজ বা ফাঁকা সংযোগ খোঁজা হয়। নেভিগেশনের জন্য index.md ও log.md-এর কথাও তিনি বলেছেন। ছোট-মাঝারি আকারে—প্রায় ১০০টি সোর্স ও কয়েক শ পেজ—এই ইনডেক্স দিয়েই কাজ চলে, আলাদা embedding-ভিত্তিক RAG অবকাঠামো লাগে না বলে তিনি মন্তব্য করেছেন। এপ্রিলের এক্স পোস্টে তিনি একটি গবেষণা উইকির উদাহরণ দিয়েছেন, যেখানে প্রায় ১০০টি নিবন্ধ ও প্রায় চার লাখ শব্দ ছিল।
ব্যবহারিক দিক থেকে তিনি Obsidian-কে IDE বা ফ্রন্টএন্ড হিসেবে দেখেন, আর LLM-কে প্রোগ্রামার হিসেবে। উইকির লেখা সাধারণত মানুষ করে না, মডেল করে। মানুষের কাজ হলো সোর্স বাছাই, দিকনির্দেশনা দেওয়া ও ভালো প্রশ্ন করা। গিস্টটি তিনি ইচ্ছাকৃতভাবে বিমূর্ত রেখেছেন—এটি একটি আইডিয়া ফাইল, নির্দিষ্ট সফটওয়্যার নয়। ঠিক কোন ফোল্ডার কাঠামো হবে, তা ডোমেইন ও পছন্দের ওপর ছেড়ে দিয়েছেন।
শাওনের পোস্ট ও @rvaniaaaa-এর বিশ্লেষণে যে ‘তিন ফোল্ডার ও একটি ফাইল’ বিন্যাস জনপ্রিয় হয়েছে, সেটি এই ধারণাকে কাজে লাগানোর একটি স্পষ্ট রূপ। raw/ ফোল্ডারে কাঁচা ইনপুট থাকে, wiki/-এ কম্পাইলেশন হয়, output/-এ উইকির প্রসেস করা জ্ঞান থেকে লেখা বা প্রজেক্ট তৈরি হয়, আর CLAUDE.md-কে পুরো সিস্টেমের জীবন্ত নির্দেশনা হিসেবে দেখা হয়। কারপাথির এপ্রিলের এক্স পোস্টে raw/ ফোল্ডার এবং আউটপুট—markdown, Marp স্লাইড বা matplotlib ছবি—উইকিতে ফিরিয়ে জমা রাখার কথা আছে। তবে গিস্টে output/ নামে আলাদা একটি বাধ্যতামূলক ফোল্ডার নির্ধারণ করা হয়নি, আর CLAUDE.md-কে তিনি মূলত উইকির নিয়ম ও কর্মপ্রবাহের schema হিসেবে বর্ণনা করেছেন, ‘আপনি কে ও আপনার লক্ষ্য কী’ তার ব্যক্তিগত প্রোফাইল হিসেবে নয়। এই প্যাকেজিংটি জনপ্রিয় ব্যাখ্যার অংশ, মূল গিস্টের নির্ধারিত নকশা নয়।
Notion, Obsidian বা অন্য নোট অ্যাপে মানুষ নিজে নোট জমায়, ট্যাগ করে, পরে খুঁজে বের করে। সেটি মূলত স্টোরেজ ও রিট্রিভাল। কারপাথির প্রস্তাবে Obsidian থাকতে পারে, কিন্তু উইকি লেখে ও রক্ষণাবেক্ষণ করে LLM। RAG প্রতি প্রশ্নে কাঁচা খণ্ড থেকে উত্তর গড়ে; কম্পাইল্ড উইকিতে সংযোগ, সারসংক্ষেপ ও অমিলের চিহ্ন আগেই তৈরি থাকে। এতে জ্ঞান সময়ের সঙ্গে জমে। তবে এটি RAG-এর সব ব্যবহারের বিকল্প নয়। কারপাথি নিজেই বলেছেন, ছোট-মাঝারি স্কেলে ইনডেক্স যথেষ্ট; উইকি বড় হলে আলাদা সার্চ টুল লাগতে পারে।
শাওন তাঁর পোস্টে একটি গুরুত্বপূর্ণ সতর্কতা তুলেছেন: লাইব্রেরিতে একটি ভুল তথ্য এক কোণায় পড়ে থাকতে পারে, কিন্তু কম্পাইলারে খারাপ সোর্স ঢুকলে তা একসঙ্গে অনেকগুলো পেজকে প্রভাবিত করতে পারে। @rvaniaaaa-এর বিশ্লেষণেও একই ঝুঁকির কথা বলা হয়েছে। কারপাথির গিস্টে এই নির্দিষ্ট উদাহরণটি নেই, তবে তিনি স্পষ্ট করেছেন যে মানুষের মূল কাজ সোর্স বাছাই ও মান নিয়ন্ত্রণ। ইনফোগ্রাফিক ও পোস্টে যে দাবি করা হয়েছে—মেইনটেন্যান্স ক্লান্তিতে তিন মাসে ব্যক্তিগত উইকির বড় অংশ অকেজো হয়ে যায়—সেই নির্দিষ্ট হিসাব কারপাথির গিস্টে পাওয়া যায়নি। তিনি এটুকু বলেছেন, রক্ষণাবেক্ষণের বোঝা মূল্যের চেয়ে দ্রুত বাড়ে বলে মানুষ উইকি ছেড়ে দেয়, আর LLM সেই বোঝা কমাতে পারে।
আরেকটি সীমা হলো, এটি কোনো তৈরি প্রোডাক্ট নয়। গিস্ট পেজে এখন ‘৫,০০০+’ স্টার দেখা যাচ্ছে; প্রকাশের কয়েক দিনের মধ্যে পাঁচ হাজার স্টার ছাড়িয়েছিল বলে শাওনসহ কয়েকটি আলোচনায় উঠেছে। GitHub গিস্ট কাউন্টার প্রায়ই ‘৫,০০০+’ পর্যন্ত দেখায়, তাই এখনকার সঠিক সংখ্যা এই পেজ থেকে নিশ্চিতভাবে বলা যাচ্ছে না। ধারণাটি ছড়িয়ে পড়ার পর অনেকে নিজের করে বাস্তবায়ন করেছেন, কিন্তু কারপাথি নিজে কোনো নির্দিষ্ট অ্যাপ প্রকাশ করেননি।
বাংলাদেশি ডেভেলপার ও নলেজ ওয়ার্কারদের জন্য এই কর্মপ্রবাহের আকর্ষণ এই যে, শুরু করতে বড় vector database বা জটিল RAG পাইপলাইন লাগে না। markdown ফাইল, একটি ফোল্ডার কাঠামো এবং Claude Code, Codex বা অনুরূপ এজেন্ট দিয়েই ছোট পরিসরে পরীক্ষা করা যায়। গবেষণা নোট, কোর্সের সারাংশ, টিমের অভ্যন্তরীণ উইকি বা প্রজেক্ট ডকুমেন্টেশন—যেখানে তথ্য সময়ে সময়ে জমে ও বদলায়—সেখানে এটি কাজে লাগতে পারে। তবে সুবিধা তখনই ধরা দেবে, যখন সোর্সের মান ভালো হবে এবং মানুষ সিস্টেমকে দিক দেবে। খারাপ বা যাচাইহীন সোর্স ঢুকলে ভুল তথ্য অনেক পেজে ছড়িয়ে পড়তে পারে। তাই এটি অটোপিলট নয়; মান নিয়ন্ত্রণই এখানে মানুষের আসল কাজ।
তথ্যসূত্র
- মুজাহিদুল ইসলাম শাওনের ফেসবুক পোস্ট, ১১ নভেম্বর ২০২৬, সকাল ১১টা ৪৮ মিনিট (এশিয়া/ঢাকা), https://www.facebook.com/
ShawonUIUCSE/ posts/ pfbid0Ash BoSB1ipQ v7X1fXfk c8ctg4ch yp8HPFJf c23Gkwbk sdnsrxPF xHN4PhAP g3kXLl - Andrej Karpathy, llm-wiki.md গিস্ট, ৪ এপ্রিল ২০২৬, রাত ১০টা ২৫ মিনিট (এশিয়া/ঢাকা), https://gist.github.com/
karpathy/ 442a6bf5 55914893 e9891c11 519de94f - Andrej Karpathy, ‘LLM Knowledge Bases’, এক্স পোস্ট, ২ এপ্রিল ২০২৬, https://x.com/
karpathy/ status/ 20398056 59525644 595 - @rvaniaaaa, ‘The Second Brain Is Not a Storage System. It’s a Compiler.’, এক্স আর্টিকেল, ২১ আগস্ট ২০২৬, রাত ১২টা ৫৩ মিনিট (এশিয়া/ঢাকা), https://x.com/
rvaniaaaa/ status/ 20905124 86738845 784